AI-MODELLEN ONTDEKKEN
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Kies een afbeelding-naar-video-API voor je bronbeeld
AANBIEDERS
 Black Forest Labs
 Grok
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI








Tijdlijn van modelreleases
Vidu Q4
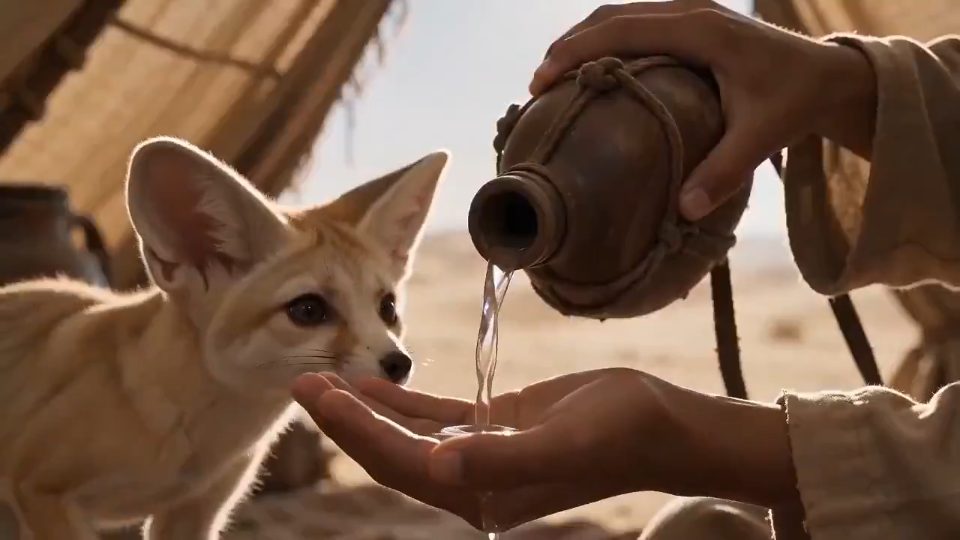
ViduVidu Q4 preview video generation with image or multi-reference guidance, audio, up to 16 seconds, and up to 4K output.
MiniMax H3 Max 16-bit Pixel
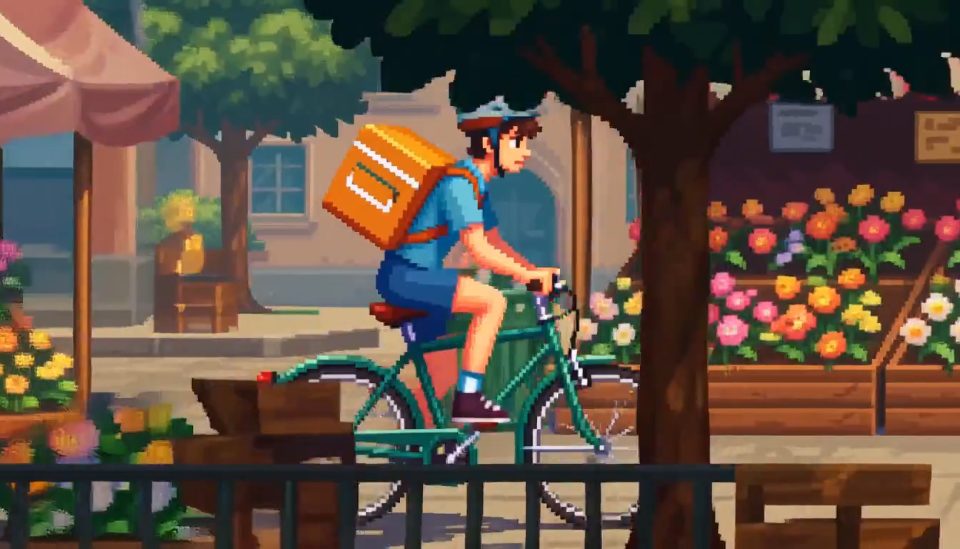
MiniMaxMaak 16-bits pixelartvideo’s met geluid in 768P van 5–15 seconden op basis van tekst of een startafbeelding.
Wan 3.0 Prime
AlibabaAlibaba Wan 3.0 Prime-videogeneratie met tekst-, beeld-, video-, audio-, document- en webpaginareferenties.
Wan 3.0
AlibabaAlibaba Wan 3.0-videogeneratie met tekst-, beeld-, video-, audio-, document- en webpaginareferenties.
MiniMax H3 Max Turbo
MiniMaxMaak video's van 5–15 seconden van tekst of afbeeldingen in 480P, 768P of 1080P.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceByteDance-videomodel van de volgende generatie voor langere verhalen met maximaal 50 multimodale referenties
MiniMax H3
MiniMaxMultimodale videogeneratie met native audio via MiniMax H3 (Hailuo 03), met uitvoer tot 2K.
Seedance 2.0 Mini
ByteDanceKostenefficiënt Seedance 2.0-videomodel van ByteDance voor snellere generatie en lagere inferentiekosten
Seedance 2.0 Fast
ByteDanceSnelle & betaalbare multimodale video met tekst-, afbeeldings-, video- en audio-invoer tot 720p
Geef een beeld een volgende actie
Een afbeelding-naar-video-API gebruikt bestaande visuele informatie. Bepaal wat moet bewegen en welke kenmerken herkenbaar moeten blijven.
Bereid het beeld voor
Kies een duidelijk onderwerp en ruimte voor beweging. Controleer tekst en fijne details vooraf.
Scheid actie en camera
Een persoon die draait verschilt van een camera die rond die persoon beweegt. Beschrijf beide afzonderlijk.
Controleer referenties
Startbeelden, eindbeelden en extra referenties zijn verschillende inputs. Niet elk endpoint ondersteunt dezelfde combinaties.
Van selectie naar een bruikbare aanvraag
Begin met een kleine, representatieve test en raadpleeg de documentatie van het endpoint.
Kies een bron
Gebruik toegestaan materiaal en noteer essentiële kenmerken.
Beschrijf de beweging
Begin met één actie en gedocumenteerde instellingen.
Vergelijk met de bron
Controleer begin, midden en einde op vervorming en visuele afwijkingen.
Afbeelding-naar-video-API: veelgestelde vragen
Verduidelijk de mogelijkheden voordat je een model integreert.
De afbeelding levert de visuele basis; de prompt stuurt beweging. Tekst-naar-video laat meer van het uiterlijk aan het model over.