AI-MODELLEN ONTDEKKEN
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Kies een tekst-naar-video-API voor jouw scène
AANBIEDERS
 Black Forest Labs
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI
 Vidu








Tijdlijn van modelreleases
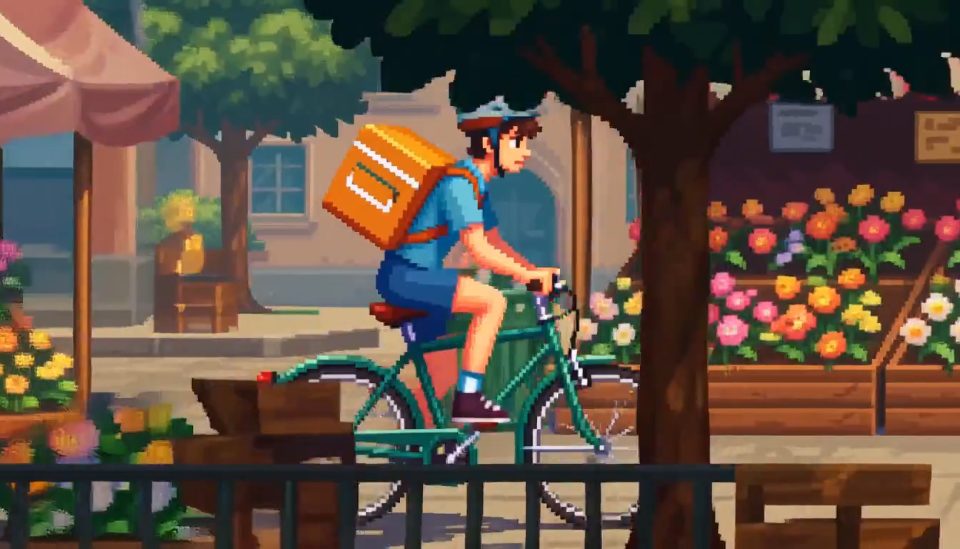
MiniMax H3 Max 16-bit Pixel
MiniMaxMaak 16-bits pixelartvideo’s met geluid in 768P van 5–15 seconden op basis van tekst of een startafbeelding.
Wan 3.0 Prime
AlibabaAlibaba Wan 3.0 Prime-videogeneratie met tekst-, beeld-, video-, audio-, document- en webpaginareferenties.
Wan 3.0
AlibabaAlibaba Wan 3.0-videogeneratie met tekst-, beeld-, video-, audio-, document- en webpaginareferenties.
MiniMax H3 Max Turbo
MiniMaxMaak video's van 5–15 seconden van tekst of afbeeldingen in 480P, 768P of 1080P.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceByteDance-videomodel van de volgende generatie voor langere verhalen met maximaal 50 multimodale referenties
MiniMax H3
MiniMaxMultimodale videogeneratie met native audio via MiniMax H3 (Hailuo 03), met uitvoer tot 2K.
Seedance 2.0 Mini
ByteDanceKostenefficiënt Seedance 2.0-videomodel van ByteDance voor snellere generatie en lagere inferentiekosten
Seedance 2.0 Fast
ByteDanceSnelle & betaalbare multimodale video met tekst-, afbeeldings-, video- en audio-invoer tot 720p
HappyHorse 1.1
AlibabaHappyHorse 1.1 ondersteunt tekst-naar-video, afbeelding-naar-video en referentie-naar-video met uitgebreidere beeldverhoudingen.
Maak van een idee een concrete opname
Een tekst-naar-video-API genereert bewegende beelden vanuit een beschrijving. Selecteer modellen op het gewenste resultaat en controleer daarna de beschikbare instellingen.
Beschrijf één actie
Benoem onderwerp, handeling, omgeving en cameragedrag. Begin met één productrotatie voordat je meerdere scènes probeert.
Vergelijk dezelfde opdracht
Beoordeel continuïteit, beweging en compositie met vergelijkbare instellingen. Duur, resolutie en prijs verschillen per endpoint.
Bepaal of geluid nodig is
Bekijk Video met audio voor dialoog of omgevingsgeluid. Controleer de audio-instellingen afzonderlijk.
Van selectie naar een bruikbare aanvraag
Begin met een kleine, representatieve test en raadpleeg de documentatie van het endpoint.
Schrijf de opname uit
Scheid noodzakelijke details van optionele stijlkeuzes.
Lees de documentatie
Controleer invoervelden, uitvoeropties en het ophalen van resultaten.
Beoordeel de hele video
Bewaar instellingen en controleer beweging en onderwerp voordat je opschaalt.
Tekst-naar-video-API: veelgestelde vragen
Verduidelijk de mogelijkheden voordat je een model integreert.
Een tekstprompt vormt de basis. Het endpoint bepaalt aanvullende velden en limieten.